
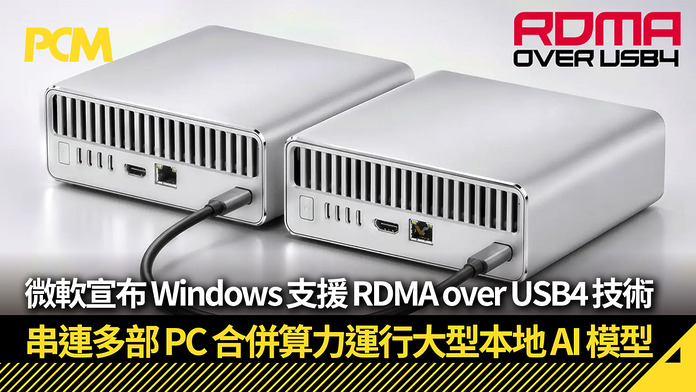
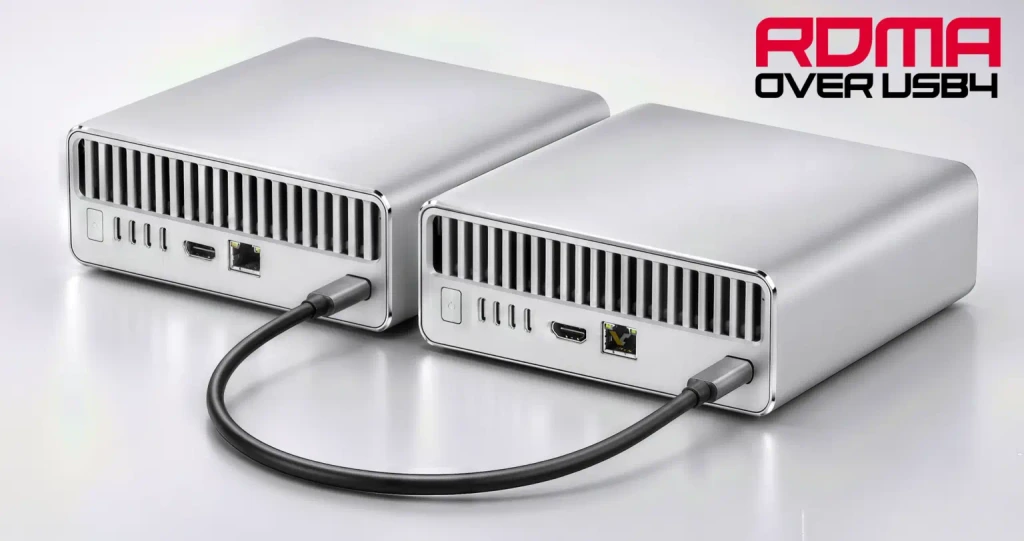
本地端運行大型語言模型(LLM)向來極度考驗電腦的記憶體容量與顯示核心效能,單機往往難以負荷。微軟 (Microsoft) 近日正式宣布為 Windows 推出「RDMA over USB4」開發者預覽功能,允許用戶透過標準 USB4 連接線將多部 PC 串連,合併各機的記憶體與 GPU 算力,共同運行單一大型本地 AI 模型。
免買昂貴網卡 標準 USB4 線材實現超低延遲
過往在數據中心或 AI 運算叢集中,系統多數依賴 NVIDIA ConnectX 等專用網絡介面卡及高速交換器,透過 RDMA(遠端直接記憶體存取)技術進行多機協同。微軟今次將 RDMA 技術引入消費級 Windows 平台的 USB4 介面上,支援 40 Gbps 及 80 Gbps 傳輸頻寬,且無需額外添置專用網卡、交換器或第三方驅動程式。
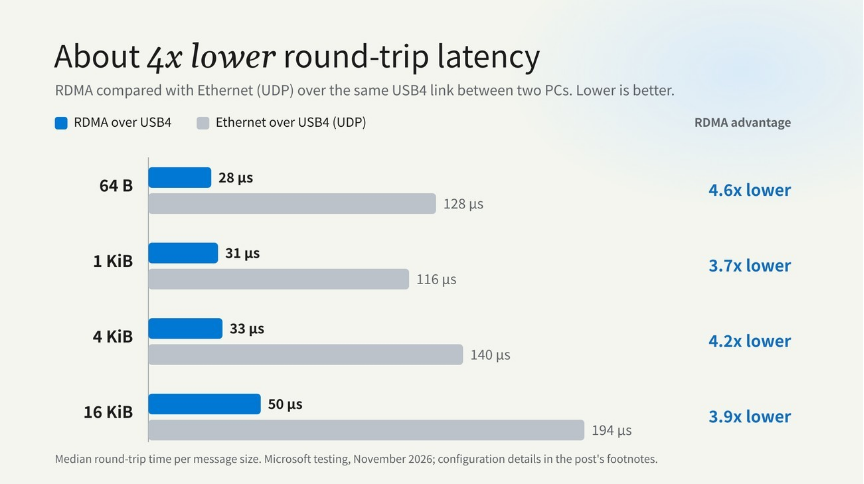
官方數據顯示,透過 RDMA over USB4 傳輸小型封包的往返延遲(Round-trip latency)可大幅壓低至約 28 至 50 微秒,較同一 USB4 連接下的傳統 UDP 網絡協定快約四倍,讓數據能在多部電腦之間直接高速調度。
AMD、Intel 實測示範 三機聯手流暢跑 235B 巨型模型
微軟聯同 AMD 及 Intel 展示了多組實機測試成績,證明該技術能有效突破單機記憶體容量限制:
- AMD 平台實測:微軟使用三部配備 AMD Ryzen AI Max+ 395 處理器(內置 Radeon 8060S 圖像核心及每部 128GB 統一記憶體)的 Mini PC 進行串連,成功運行採用 4-bit 量化的 Qwen3-235B-A22B 超大型模型。微軟錄得生成速度約為每秒 18.5 tokens,而 AMD 則在自家配置下測得每秒 21.98 tokens 的表現。
- Intel 平台實測:Intel 方面則以三部及四部配備 64GB 記憶體的 Core Ultra Series 3 系統串連運行 GPT-OSS-120B 模型,生成速度分別達到每秒 49.4 tokens 及每秒 54.2 tokens。
須採用點對點直連 將於 Windows Insider 頻道推出
在硬件連接要求方面,微軟建議使用 40 Gbps 或以上速度的 USB4 連接埠(亦兼容 Thunderbolt 4 及 Thunderbolt 5)。值得注意的是,參與運算的電腦必須採用「點對點(Mesh)」方式直接相連;以三部 PC 為例,每部機均需具備兩個 USB4 埠並使用三條連接線互相接駁。微軟特別提醒,若採用菊花鏈(Daisy-chain)方式串接,系統效能將會大幅下降。
目前該功能尚未向公眾推送,微軟計劃稍後透過 Windows Insider Experimental Channel 釋出預覽版本,而相關的 NetworkDirect 驅動程式及經修改的 llama.cpp 推理框架則已率先以開源形式發布。